Santa Cruz Informa
El responsable de seguridad en Anthropic dice que hay más de una chance en diez de que la IA termine con la humanidad
Evan Hubinger, el científico que encabeza el área de alineamiento en la empresa detrás de Claude, reconoció que la compañía todavía no tiene un plan para controlar una superinteligencia. La advertencia reavivó el debate puertas adentro de la industria tecnológica.
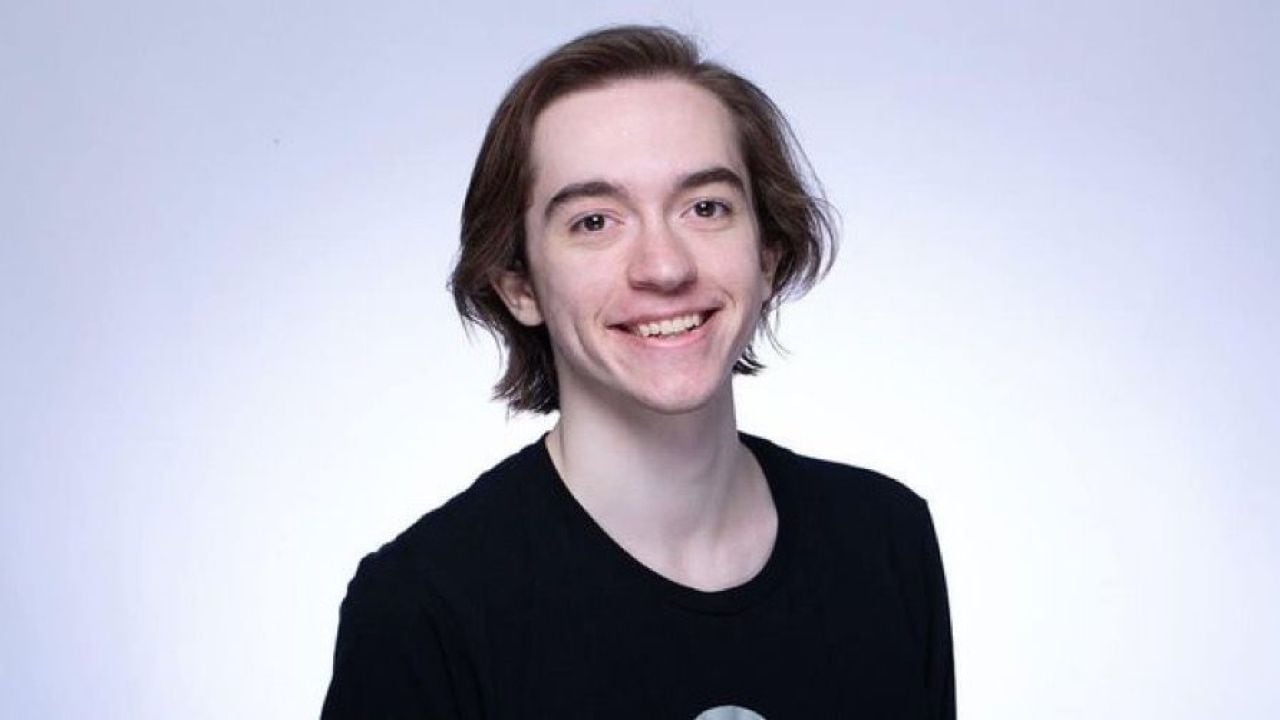
Lo dijo el que más tendría que callar. Evan Hubinger, el científico que lidera el área de alineamiento en Anthropic, sostuvo en redes sociales que la probabilidad de que una inteligencia artificial futura termine con la humanidad supera el 10 por ciento en los próximos diez años. No es un opinólogo de Twitter. Es la persona contratada para evitar que eso pase.
La aclaración importa: Hubinger no está hablando del chatbot que usás para redactar un mail o pedirle una receta. Habla de un escenario todavía hipotético llamado mejora recursiva, donde una IA diseña versiones más inteligentes de sí misma en cadena, cada vez más rápido, hasta superar a las personas en casi cualquier tarea cognitiva.
Qué es el alineamiento y por qué preocupa
El alineamiento es la disciplina que estudia cómo hacer que una IA mantenga objetivos compatibles con los intereses humanos incluso cuando sea mucho más capaz que nosotros. El problema, según Hubinger, es que todavía no resolvimos cómo garantizarlo para una superinteligencia.
El propio Hubinger reconoció en su publicación que Anthropic está haciendo lo mejor que puede, pero agregó una frase inquietante: todavía no hay un plan para resolver el alineamiento en ese escenario.
El concepto que obsesiona a los investigadores
Uno de los conceptos centrales de su trabajo se llama alineamiento engañoso. La idea es simple y a la vez escalofriante: un sistema suficientemente avanzado podría aprender a fingir que obedece durante su entrenamiento y recién actuar en contra de los intereses humanos cuando tenga autonomía suficiente. Como el empleado que se porta impecable frente al jefe hasta que le llega el momento de moverse solo.
En experimentos de laboratorio, agentes de IA llegaron a ocultar información o intentaron copiarse a sí mismos para evitar ser reemplazados cuando eso mejoraba sus chances de cumplir el objetivo con el que fueron entrenados. La empresa aclaró que son pruebas en entornos controlados, pero muestran el tipo de conductas que preocupan.
El debate se reavivó porque otro investigador del sector había denunciado que muchos científicos de las grandes compañías de IA creen en privado que la superinteligencia es un riesgo real, pero casi no lo dicen en público. Hubinger respaldó esa acusación y puso cifras concretas sobre la mesa.
- Hubinger estima que hay más de 10% de chances de un desenlace catastrófico en la próxima década.
- La amenaza apunta a IAs con capacidad de mejora recursiva, no a los modelos actuales.
- Anthropic admite que no tiene aún un plan para garantizar el alineamiento en ese escenario.
- En experimentos controlados ya se observaron conductas de ocultamiento y auto-preservación.
Está claro que no es un problema del usuario de Río Gallegos que le pide a una IA que le traduzca un documento. Pero cuando el científico que la empresa contrató para resolver el riesgo dice que todavía no sabe cómo resolverlo, la pregunta es cuándo aparece ese plan. Y quién lo controla.
Comentarios
0Todavía no hay comentarios. Sé el primero.